Reversi-motståndaren som lärde sig själv
Vad det är
Anders bygger en app för att spela Reversi, samma spel som det klassiska Othello. Den här texten är på svenska. Den heter Reversi Crown än så länge och är inte släppt till butikerna än. En av motståndarna i appen heter Juno, och Juno är en AI-modell som lärt sig spelet helt själv.
Den fick reglerna, ingenting annat. Ingen har visat den ett enda drag spelat av människor. Allt den kan har den lärt sig genom att spela mot sig själv, dygnet runt, på en laptop, tills den slog de flesta starka spelare.
Det som spelar är ett litet neuralt nät: knappt två miljoner tal som justerades lite efter varje omgång. Det tittar på brädet och svarar med två saker: vilket drag som känns bäst, och vem som ligger bäst till. Innan den väljer provar den några hundra drag framåt i huvudet. Det färdiga nätet är en fil mindre än ett foto och fungerar i appen även utan nätuppkoppling.
Varför vi byggde den
Appen har redan starka botar som heter Zenith. De bygger på minimax, det klassiska sättet att få en dator att spela brädspel: räkna några drag framåt och värdera ställningen efter handskrivna regler, till exempel att hörn är värda mycket. Den starkaste Zenith slår 95 procent av alla människor. Men det är ren matematik, inte AI.
Juno är experimentet att ta botarna ett steg till: en motståndare som ingen har programmerat, utan som lärt sig själv. Tidigare försök i molnet blev för dyra och byggde på fel metod. Den här gången kördes allt lokalt på en MacBook Pro, och driften kostade inte mer än strömmen. Frågan var om den kunde slå minimax-botarna. Svaret blev ja.
Hur den lär sig, i korthet
Tänk dig en nybörjare som spelar två tusen partier mot sig själv, tittar tillbaka på dem och frågar: vilka drag ledde till vinst? Sedan justerar den sin magkänsla en aning och spelar två tusen till. Varje sådan omgång kallar vi en generation, och den tar ungefär tio minuter.
På en natt blir det över hundra generationer, och på morgonen har den spelat fler partier än en människa hinner på en livstid.
Resan
Träningen pågick i knappt tre veckor, i tre omgångar.
- 10 septemberDet första nätet börjar från slumpmässiga tal och förlorar varje parti.
- 13 septemberEfter fyra dygn är det starkt nog för appen och blir den första Juno. Ett dubbelt så stort nät prövas, men kommer inte ikapp.
- 17 septemberEn turnering mellan versionerna visar något oväntat: näten har blivit olika snarare än bättre. Den nyaste slår den förra, som slår den dessförinnan, men den äldsta slår den nyaste. Som sten, sax och påse.
- 18 septemberVi börjar om från noll med allt vi lärt oss inbyggt: nätet får också möta äldre versioner av sig själv, och en del partier startar i ställningar ur mänskliga turneringar.
- 22 septemberMed ett nytt, pålitligt sätt att mäta väljs den bästa versionen hittills till appen. Den kallas generation 567 och spelar där fortfarande.
- 26 septemberJuno slutar ta hjälp av en exakt räknare på slutet och blir helt och hållet ett tränat nät, lika stark som förut.
- 28 septemberOmstarten har kommit i nivå med 567 men inte förbi. Vi avslutar efter 3,8 miljoner partier och är nöjda med nätet i appen.
Hur bra den blev
Starkare än Zenith, och i öppning och mittspel bättre än världsmästarna. En tidig version av Juno vann 378 av 400 partier mot den starkaste Zenith. Nätet i appen i dag vinner ungefär vart tredje parti mot Egaroucid, ett av världens starkaste Reversi-program, på dess nivå 7.
Vi jämförde också Junos drag med människornas i trettio års VM-partier. Domaren var Egaroucid, som räknade ut hur många brickor varje drag kostade jämfört med det bästa. I öppningen och mittspelet tappar Juno mindre än hälften så mycket som VM-spelarna. I slutspelet är de jämbördiga.
Hur det är att spela mot den
Styrka är en sak. Det som gör Juno värd att möta är hur den vinner. Tre saker känner man igen, och alla tre går att mäta.
Den ser ut att ligga under. I Reversi är många brickor mitt i partiet en nackdel: varje bricka du har är en bricka motståndaren kan vända. Juno har kommit på det själv och drar det längre än människor gör. Mot en spelare som alltid tar så många brickor som möjligt har Juno efter trettio drag ofta bara en handfull, och vinner ändå stort.
Den tar ifrån dig dragen. Juno väljer tysta drag som inte öppnar nya rutor åt motståndaren. Mot en spelare som gärna tar brickor har motståndaren mot slutet av mittspelet ofta bara två eller tre drag att välja på, och alla är dåliga: ge bort ett hörn eller öppna en kant.
Den tar hem partiet på slutet. Läget den byggt upp med få brickor och många egna drag vänder den på slutet till en klar seger. Zenith spelar annorlunda: den värderar hörn och brickor efter en formel och räknar sex drag framåt, stark men mekanisk. Juno spelar på sådant som ger utdelning trettio drag senare.
Så såg träningen ut
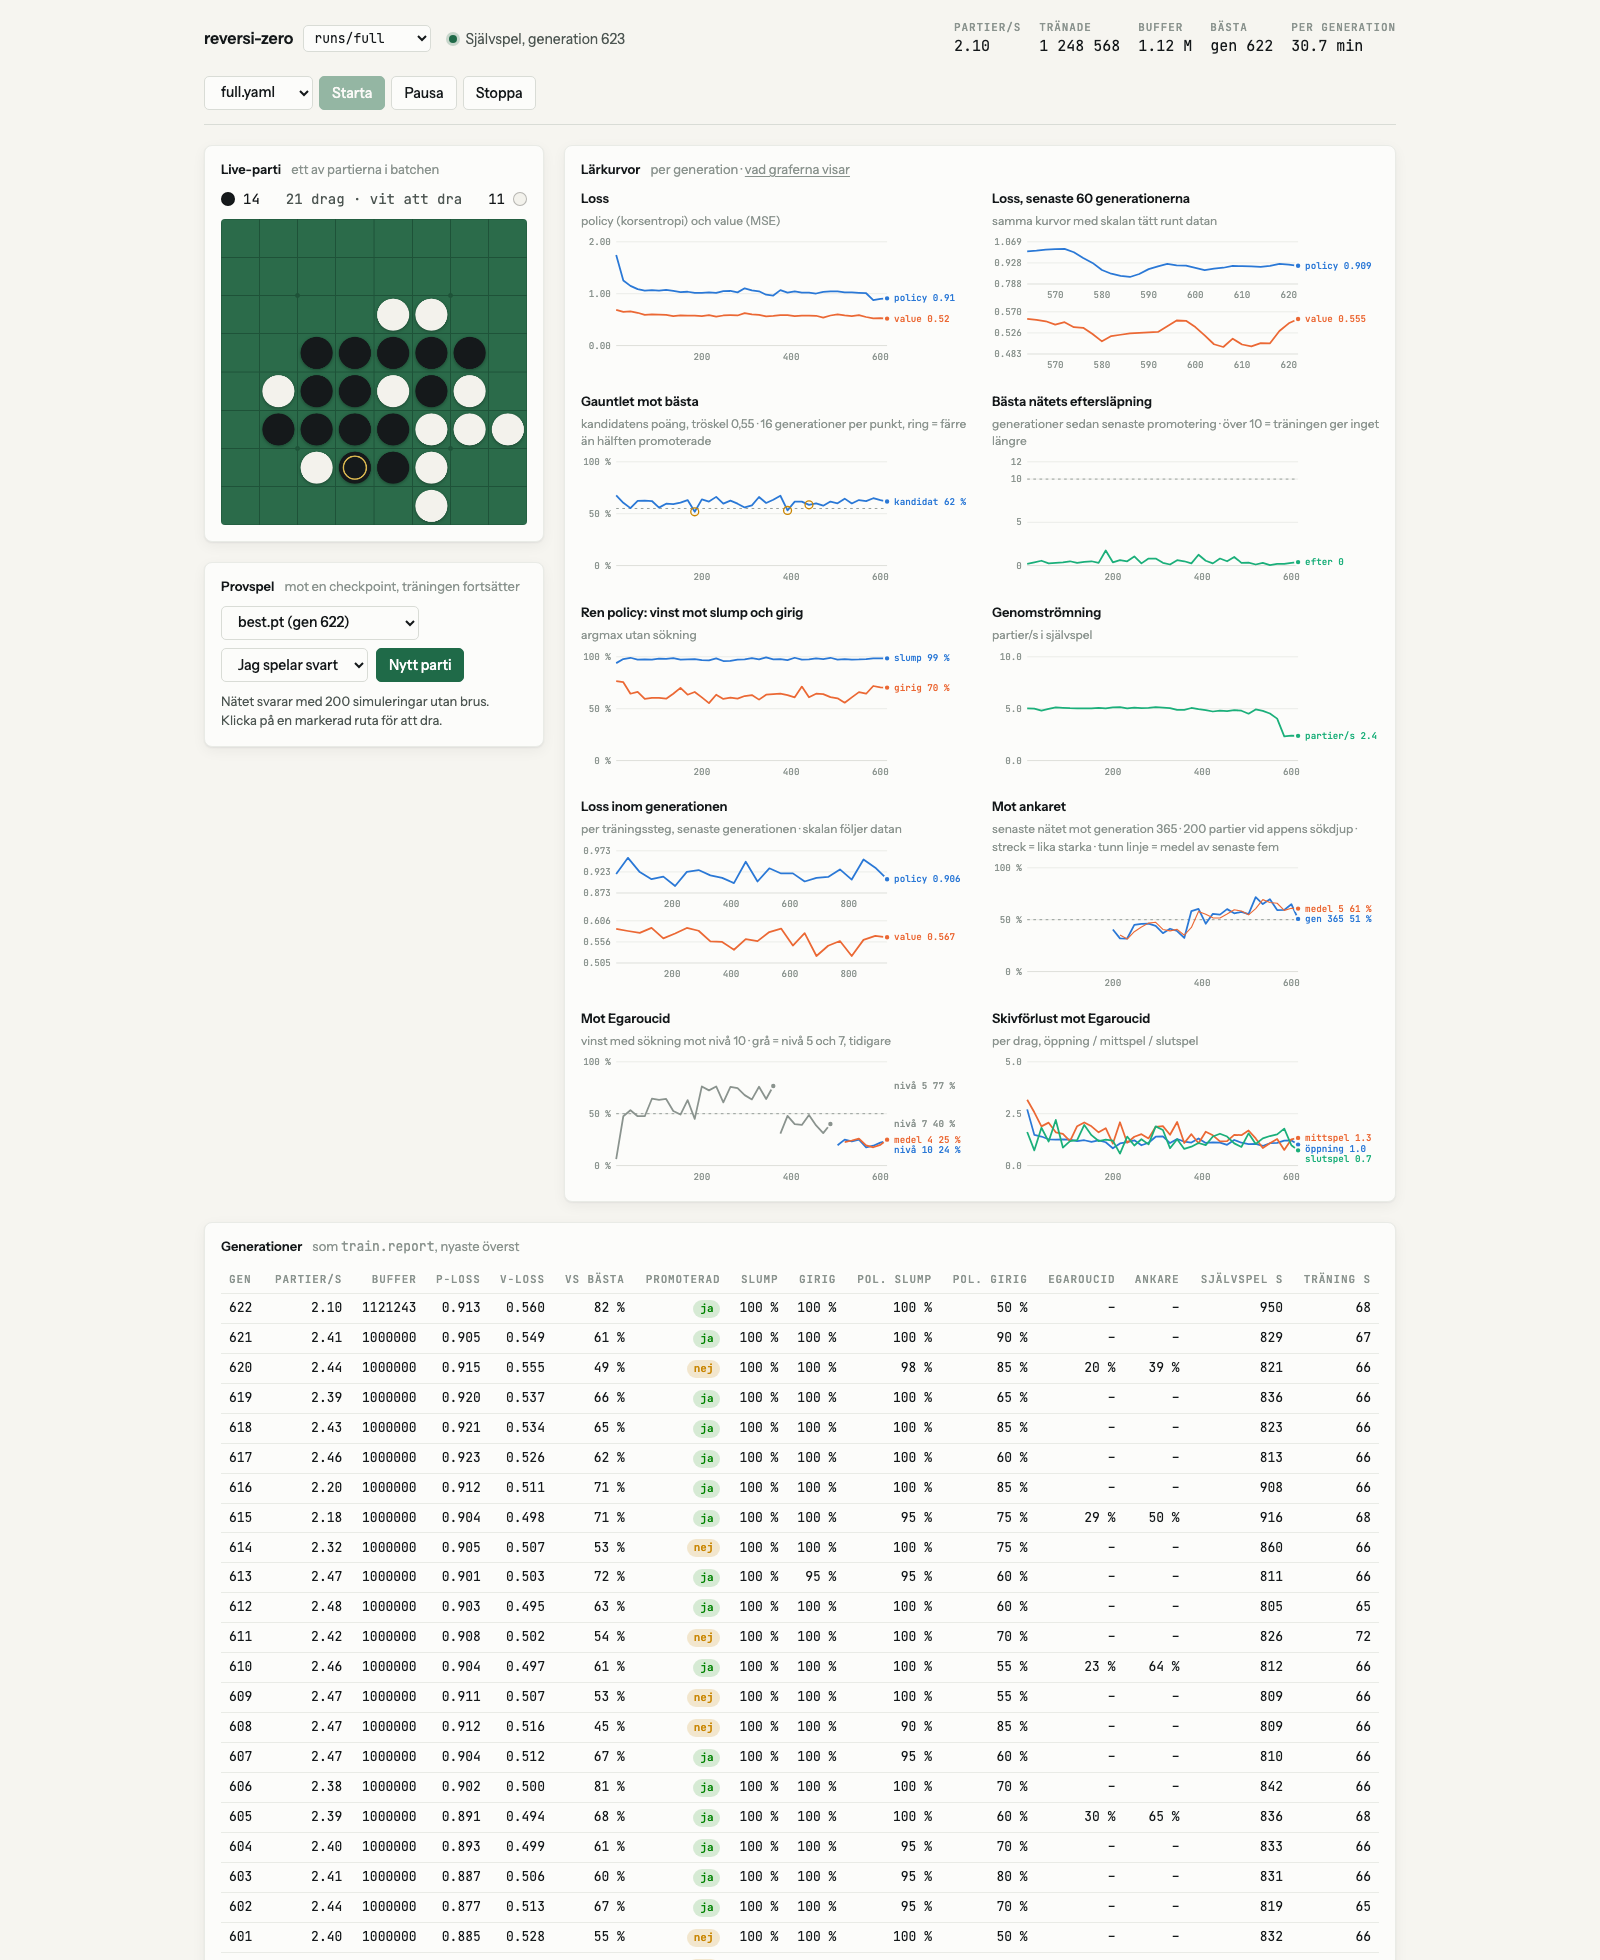
Medan den tränade kunde vi följa ett av partierna live, tillsammans med kurvorna över hur den utvecklades.
Frågor och svar
Vilken AI-modell använder ni?
Ingen färdig. Det är inte ChatGPT, Claude eller Gemini, utan ett eget litet nät som började med slumpmässiga tal och bara kan en sak: spela Reversi. En språkmodell har hundratals miljarder tal och har läst nästan allt som skrivits. Den här har ett par miljoner och har aldrig sett en text. Koden till verkstaden är skriven tillsammans med Claude, Anthropics AI-assistent, men den som spelar är helt vår egen.
Är det verkligen inlärning?
Ja, i den mest bokstavliga meningen. Tänk på den lilla robotbilen som ska hitta genom en labyrint: i början krockar den mot väggarna, efter många försök tar den sig igenom felfritt, och ingen har visat den vägen. Juno är samma sak, med ett bräde i stället för ett golv. Det kallas förstärkningsinlärning.
Vi kan till och med se krockarna. Ett hörn i Reversi kan aldrig vändas. Efter två tusen partier tog nätet hörnet bara var fjärde gång det kunde. Fyra tusen partier senare tog det hörnet fyra gånger av fem. Och sedan något finare: det slutade ta hörn så ofta, eftersom en stark spelare vet att hörnet oftast står kvar och att något annat är värt mer just nu. Regeln byttes mot omdöme, och ingen sa åt den att göra det.
Är det inte samma sak som ChatGPT, fast sämre?
Skillnaden talar för Juno. ChatGPT är tränad på text som människor skrivit och härmar i grunden dem. Juno fick bara reglerna och en förlust efter en annan, och ur det växte strategi som ingen berättat om. Om ChatGPT är en läsare är Juno en upptäckare. Och ChatGPT kan inte spela Reversi: den bryter mot reglerna efter några drag.
Tänker den?
Det är en filosofisk fråga som ingen kan avgöra. Om den lärde sig är däremot inte filosofi. Den första versionen förlorade varje parti. Versionen i appen slår de flesta starka spelare. Däremellan finns bara regler och resultat.
Har den aldrig sett mänskliga partier?
Nätet i appen har aldrig sett något mänskligt alls. I omstarten fick en del partier börja i en ställning ur en mänsklig turnering, men nätet fick aldrig veta vad människan spelade där. Arkivet bidrog med frågor, aldrig med svar.
Varför slutade ni träna?
För att den inte blev bättre längre, mätt på ett sätt vi litar på. Omstarten prövade flera förbättringar, men ingen version gick tydligt förbi nätet i appen, och ett större nät gav inte fler vinster. Nästa kliv hade krävt mycket mer datorkraft. Vår tränade AI-modell Juno räcker gott: den slår Zenith och har en spelstil som är roligare att möta.
Del 2 berättar hur: Så lär sig nätet Reversi, om vad datorn ser, vad ett neuralt nät är, sökningen, träningsvarvet och vägen till telefonen.